
Lanciare un A/B test è la parte facile. Analizzarlo in modo onesto è dove la maggior parte dei team sbaglia — spesso senza saperlo.
Il problema non è la mancanza di strumenti: VWO, AB Tasty, Optimizely e simili ti danno grafici colorati e percentuali di “probabilità di vincita” in tempo reale. Il problema è che quei numeri si prestano a letture comode ma scorrette. Si vede il verde, si dichiara vincitore, si manda in produzione. E poi ci si chiede perché il fatturato non si muove.
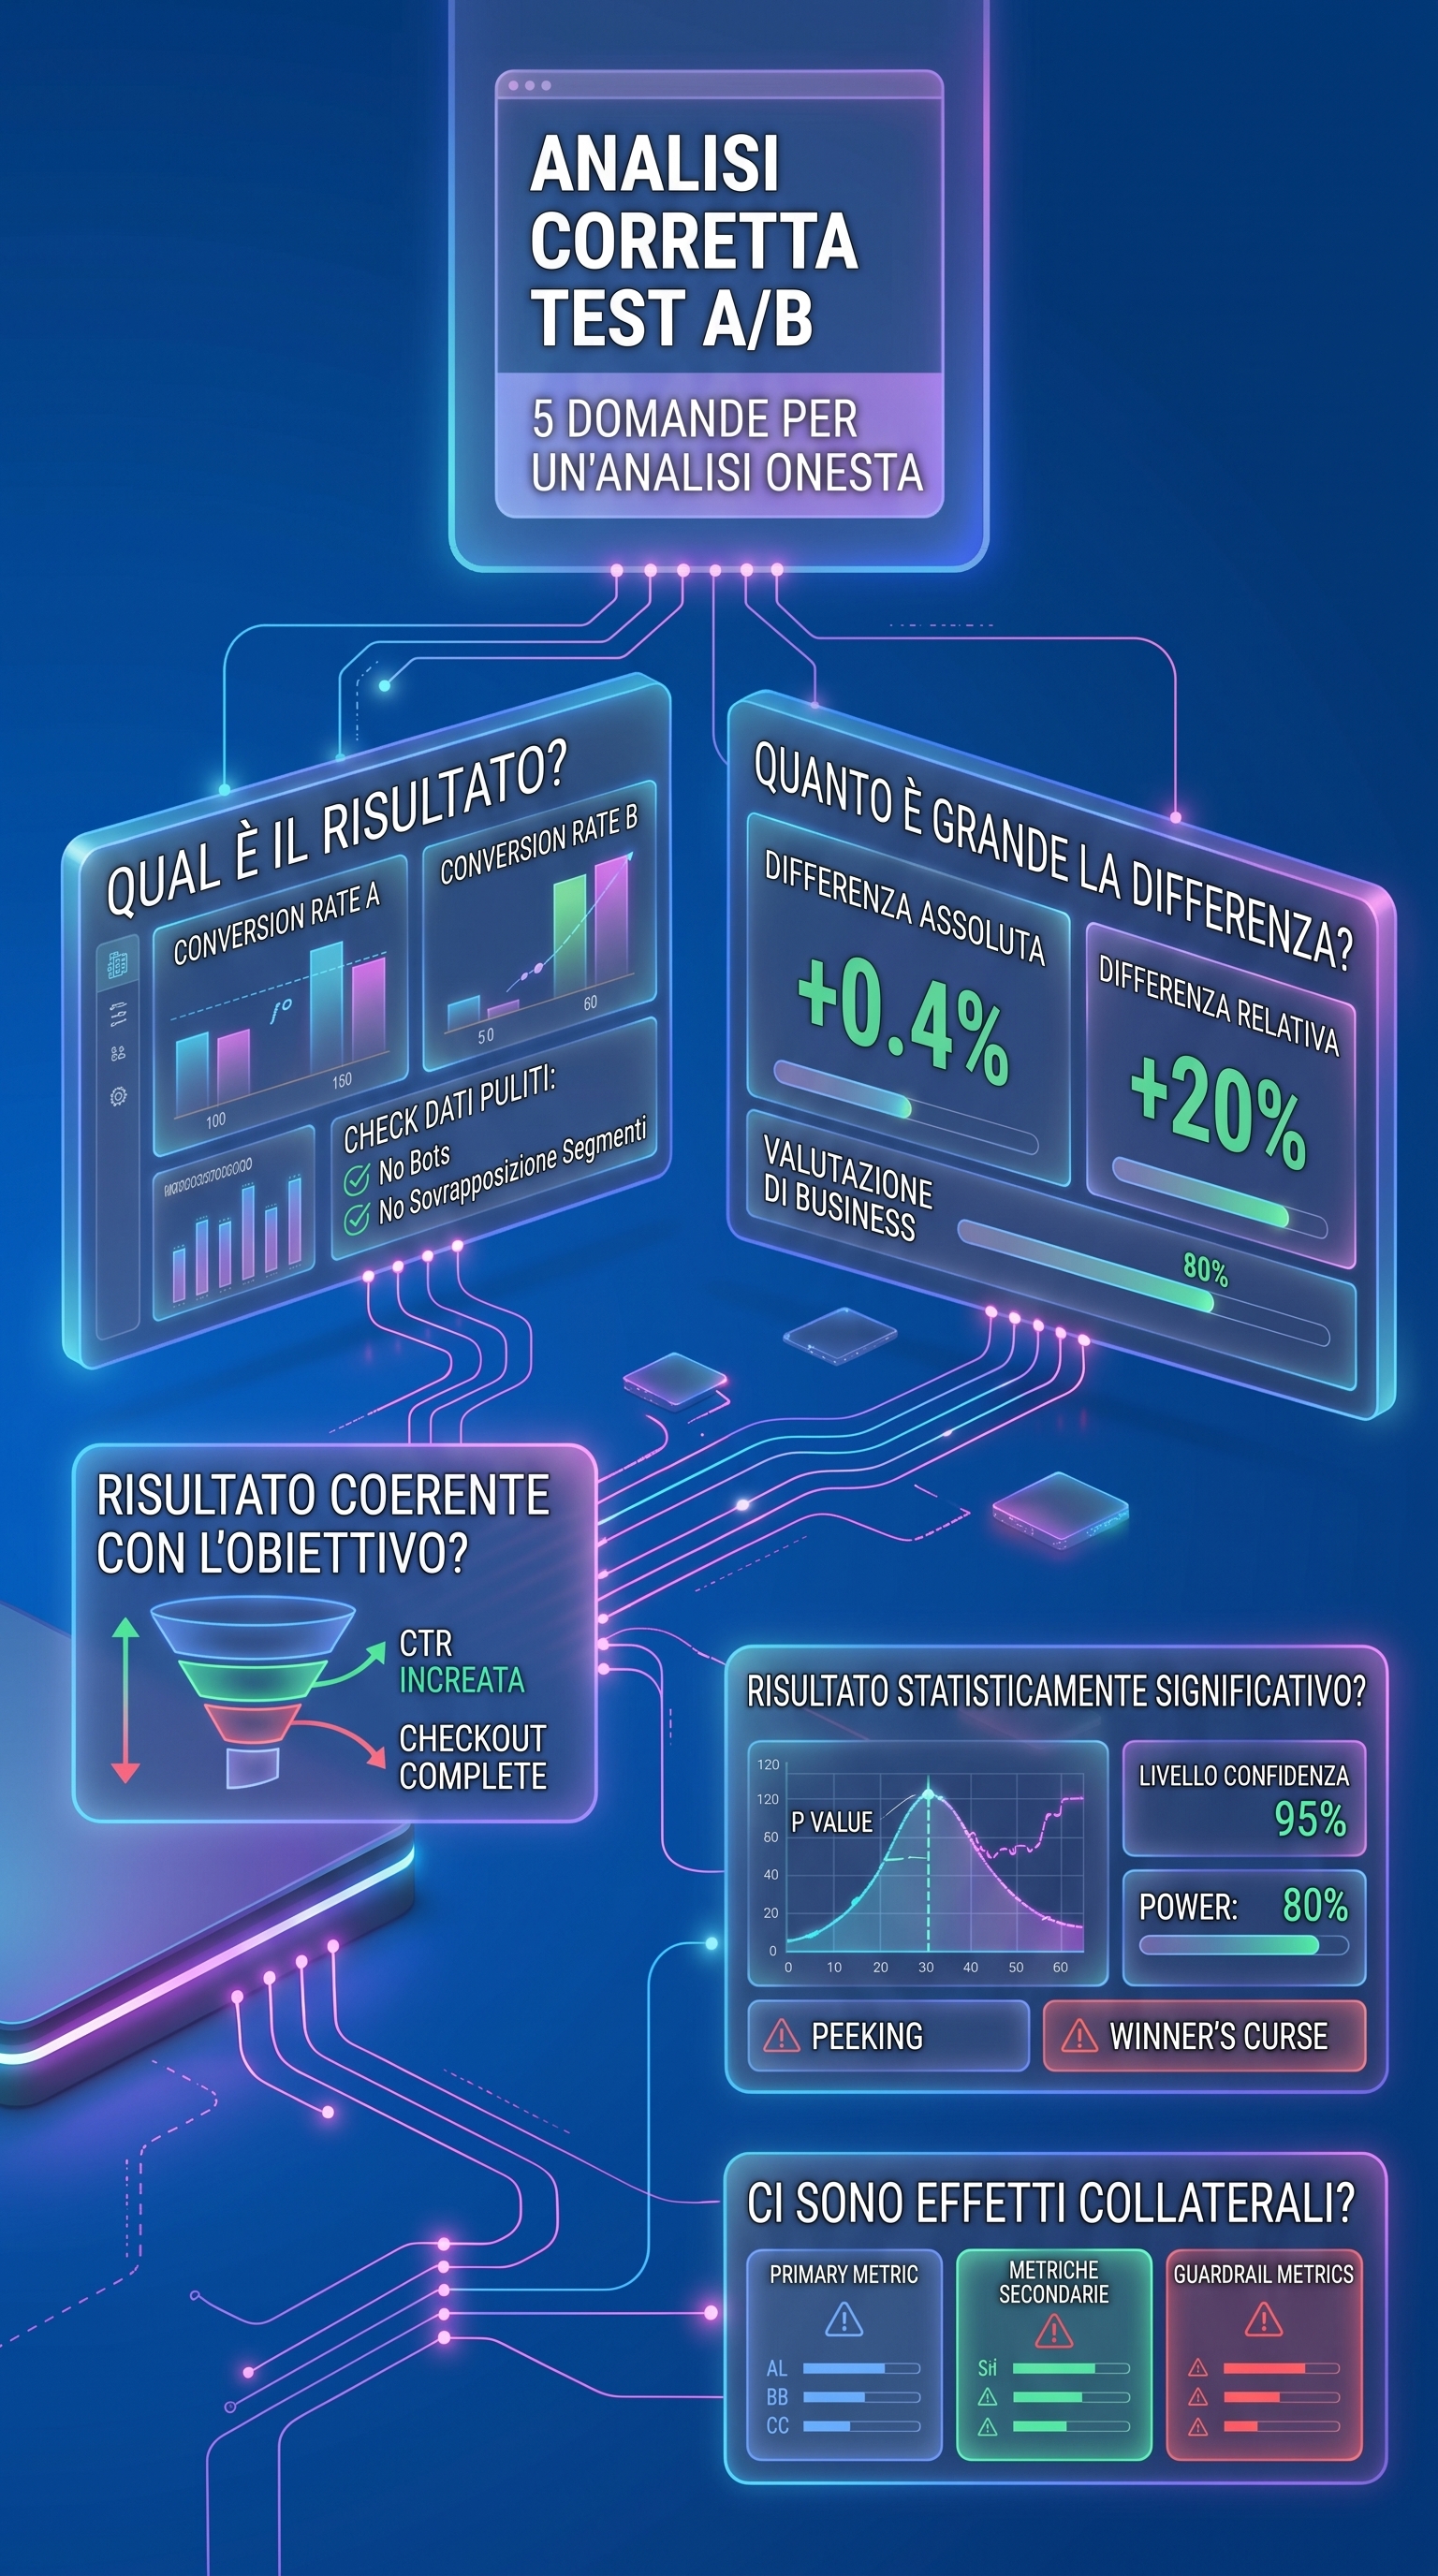
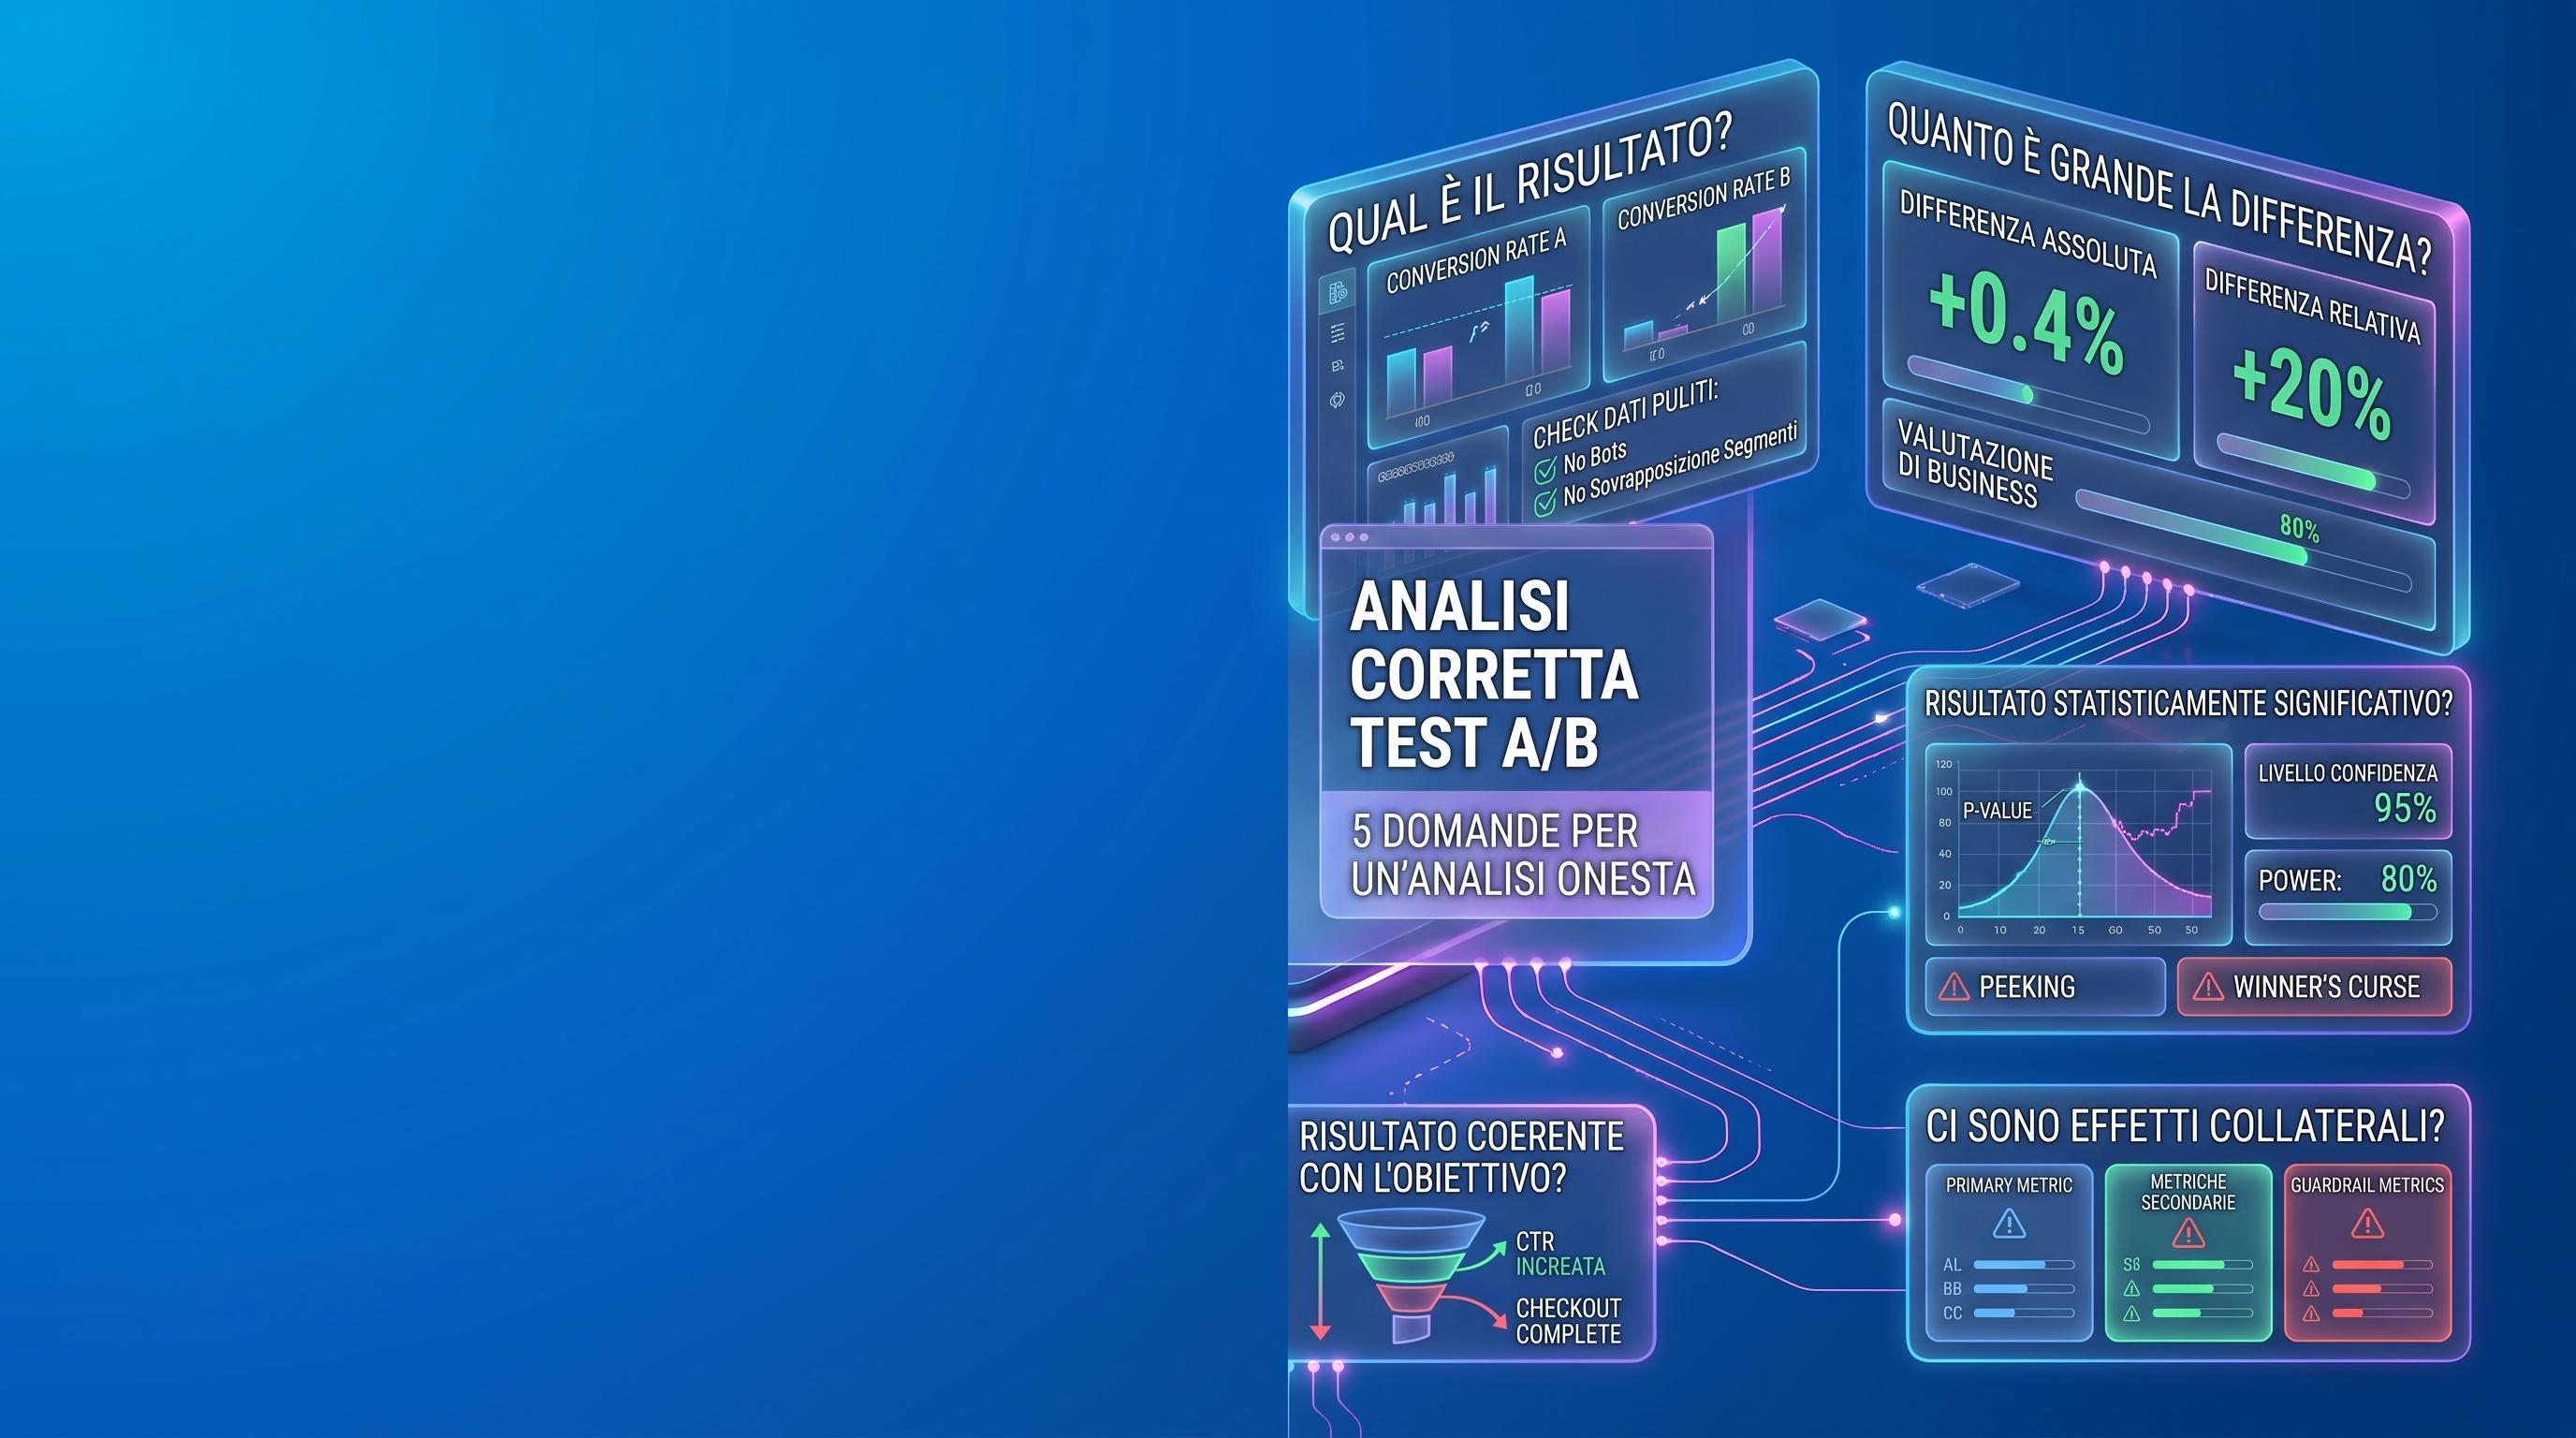
Una buona analisi dovrebbe rispondere almeno a cinque domande, in quest’ordine.
1. Qual è il risultato?
Prima di tutto, guarda cosa è successo concretamente. Variante A: tasso di conversione X%. Variante B: tasso di conversione Y%. Chi ha fatto meglio?
Sembra banale, ma la prima cosa da verificare è che i dati siano puliti: niente traffico bot, niente sovrapposizione di segmenti, niente problemi di campionamento (l’utente che vede prima A e poi B perché i cookie sono stati cancellati). Uno strumento di A/B testing può dichiararti un vincitore anche su dati inquinati — non ha modo di saperlo da solo.
Controlla anche la distribuzione temporale: se la variante B ha ricevuto tutto il traffico il venerdì pomeriggio mentre A lo ha ricevuto il lunedì mattina, stai confrontando due comportamenti d’acquisto diversi, non due design.
2. Quanto è grande la differenza?
Qui entra in gioco una distinzione che in molti saltano: la differenza assoluta e quella relativa non sono la stessa cosa, e solo insieme raccontano la storia completa.
Supponiamo che la variante A converta al 2,0% e la variante B al 2,4%. La differenza assoluta è 0,4 punti percentuali. La differenza relativa è +20%. Entrambe le cifre sono corrette — ma usarle nel contesto sbagliato dà impressioni molto diverse.
Il +20% sembra enorme. Ma se il tuo volume mensile è 5.000 visite, stai parlando di 20 conversioni in più al mese. Vale la pena di sviluppare e mantenere quella variante? Dipende da quanto costa la conversione, da quanto vale il cliente nel tempo, da quanto costa implementare la modifica. La statistica da sola non risponde a queste domande — ci vuole il contesto di business.
Viceversa, un +0,3 punti percentuali assoluti su un e-commerce da 500.000 visite mensili può valere centinaia di migliaia di euro l’anno. Lì l’assoluto è piccolo ma il valore è concreto.
Regola pratica: riporta sempre entrambe le cifre, e aggiungi sempre una stima dell’impatto in unità di business reali — ordini, lead, ricavi. È l’unico modo per capire se vale la pena agire.
3. Il risultato è statisticamente significativo?
Questa è la sezione che la maggior parte dei team legge male — spesso per colpa degli strumenti stessi, che mostrano la significatività in tempo reale.
Il concetto di significatività statistica risponde a una domanda precisa: qual è la probabilità che la differenza osservata sia frutto del caso? Il livello standard nell’industria è 95% di confidenza, che corrisponde a un p-value di 0,05 — ovvero accetti una probabilità del 5% di dichiarare un vincitore quando in realtà non c’è nessun effetto reale (falso positivo, o errore di tipo I).
Il problema è che questo 5% si accumula. Se lanci 10 test, la probabilità di incorrere in almeno un falso positivo sale verso il 40%. E se guardi i risultati continuamente invece di aspettare la fine del test — la pratica del cosiddetto peeking — la situazione peggiora ancora. Evan Miller ha quantificato questo effetto: se controlli i risultati dopo ogni batch di nuovi dati e ti fermi non appena vedi p < 0,05, il tasso reale di falsi positivi non è il 5% promesso, ma il 26%.
Legato alla significatività c’è il concetto di potenza statistica (statistical power): la probabilità che il test rilevi un effetto reale quando c’è davvero. Lo standard di settore è 80%, il che implica un 20% di probabilità di non vedere un effetto reale anche quando esiste. Per raggiungere quella potenza serve calcolare la dimensione del campione prima di lanciare il test — non durante, non dopo.
La maggior parte dei team salta questo calcolo e fa girare il test “finché non è significativo” oppure “per due settimane”, qualunque cosa arrivi prima. Questo porta a quello che viene chiamato il winner’s curse: in un test sottodimensionato, la variazione casuale è grande rispetto all’effetto reale, e i risultati significativi che emergono tendono a sovrastimare l’effetto vero. Il test sembra aver trovato qualcosa di solido — in realtà ha solo fatto rumore.
Per fare le cose per bene servono tre input prima di partire: il tasso di conversione baseline, il Minimum Detectable Effect (MDE, cioè la variazione minima che vale la pena rilevare per il business), e il livello di confidenza scelto. Da lì si ricava la dimensione del campione necessaria — e solo a quel punto si lancia il test, si aspetta il raggiungimento del campione, e si legge il risultato una volta sola.
Un altro elemento spesso trascurato è la durata minima: anche se raggiungi il campione in tre giorni, dovresti comunque far girare il test almeno sette giorni per catturare la variabilità settimanale del comportamento degli utenti (il lunedì e il sabato non sono lo stesso pubblico).
4. Il risultato è coerente con l’obiettivo?
Un test può risultare statisticamente significativo e comunque essere fuorviante se non lo leggi nel contesto dell’obiettivo di business.
L’esempio classico: la variante B aumenta il CTR del pulsante di acquisto del 15%. Ottimo. Ma se il tasso di completamento del checkout scende e il tasso di reso sale, hai spostato utenti meno intenzionati nella parte bassa del funnel — non hai migliorato la performance, hai spostato il problema.
La metrica su cui hai ottimizzato il test (primary metric) potrebbe non essere la metrica che conta davvero per il business. O peggio, potrebbe essere correlata negativamente ad essa. Prima di dichiarare un vincitore, verifica che la variante non stia solo spostando traffico tra fasi del funnel senza creare valore netto.
Questo è il motivo per cui definire la primary metric prima di lanciare il test è fondamentale — non dopo aver visto i dati, quando il bias di conferma inizia a fare il suo lavoro.
5. Ci sono effetti collaterali?
Ottimizzare una metrica senza guardare il contesto è una delle fonti principali di decisioni sbagliate nell’A/B testing.
Per questo è utile strutturare le metriche in tre livelli:
-
Primary metric: quella su cui il test è stato progettato e che determina il vincitore. Ce n’è una sola per test — averne due o tre rende l’analisi ambigua per definizione.
-
Metriche secondarie: indicatori correlati che aiutano a capire perché la variante ha funzionato (o non ha funzionato). Se la conversione sale ma il tempo sul sito crolla, c’è qualcosa da capire nel comportamento.
-
Guardrail metrics: metriche che non devono peggiorare, pena l’invalidazione del risultato. Se la variante aumenta le conversioni ma fa impennare il tasso di rimborsi, il tasso di errori del carrello o i costi di assistenza clienti, il test non è un successo — è un danno mimetizzato.
Le guardrail metrics sono il safety net dell’analisi. Definirle a priori — e non spostarle a posteriori — è ciò che separa un programma di sperimentazione serio da uno che si racconta storie.
In sintesi
Un A/B test non si analizza guardando la barra verde dello strumento. Si analizza verificando che i dati siano puliti, calcolando l’impatto reale in termini di business, controllando che la significatività statistica non sia frutto di peeking o di un test sottodimensionato, e leggendo il risultato su tutte le metriche rilevanti — non solo quella che fa più comodo.
La realtà è che la maggior parte degli esperimenti non riesce a migliorare le metriche chiave: i tassi di successo nell’industria si attestano tipicamente tra il 10% e il 20%. Non è un fallimento del metodo — è la normalità di chi fa sperimentazione seria. Significa che ogni test che dichiariamo vincitore senza rigore statistico ha un’alta probabilità di essere un falso positivo.
Il vantaggio competitivo non sta nel lanciare tanti test. Sta nell’analizzarli in modo onesto.